Forschung & Technik
RAG: Wenn KI in eigenen Dokumenten nachschlägt
Eine KI kann Antworten mit gefundenen Unterlagen verbinden. Entscheidend ist dabei, welche Dokumente sie findet – und ob sie diese richtig verwendet.
Ein Foto, eine Frage und eine gesprochene Erklärung können zusammen zum Arbeitsmaterial werden. Doch nicht jedes System verarbeitet alle Formate gleich.
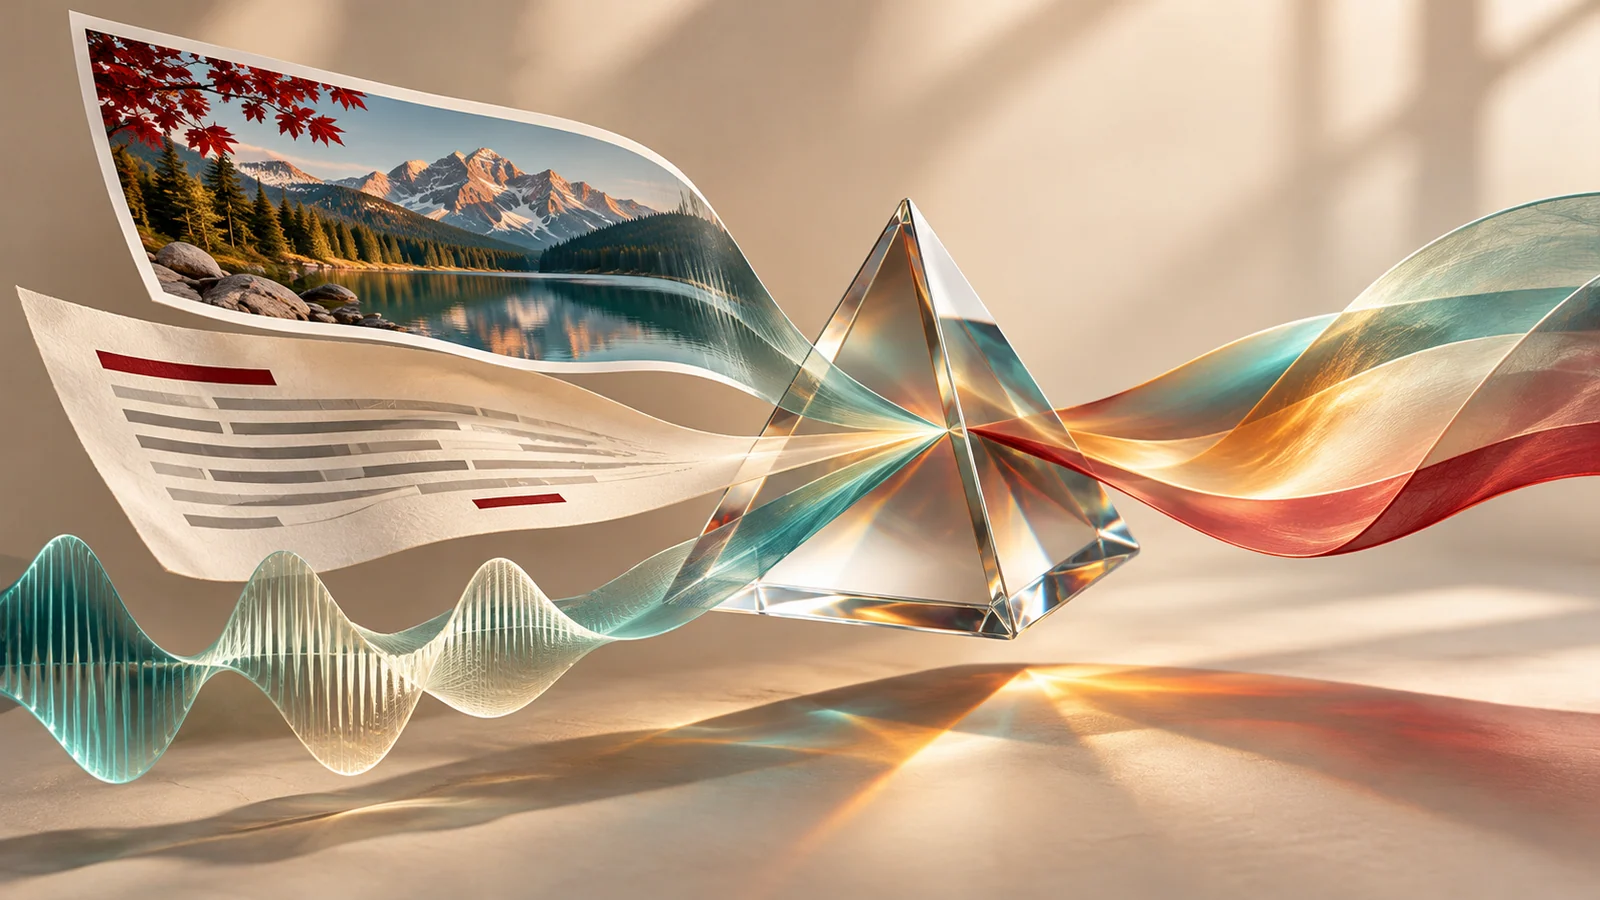
Mehr Formate ermöglichen reichere Aufgaben. Sichtbare Beobachtung und Interpretation sollten trotzdem getrennt bleiben.
Multimodal bedeutet, dass ein KI-System mit mehreren Arten von Daten arbeitet. Dazu können Text, Bilder, Audio oder Video gehören. Der Begriff sagt zunächst wenig darüber aus, welche Kombinationen eine bestimmte Anwendung tatsächlich unterstützt. Manche Systeme nehmen Bilder und Text entgegen, antworten aber ausschließlich schriftlich. Andere können auch Sprache oder Bilder erzeugen. Eingabe und Ausgabe müssen deshalb getrennt betrachtet werden.
Der Gemini-Forschungsbericht beschreibt Modelle, die Informationen aus Bild, Audio, Video und Text verarbeiten. Googles Dokumentation zur Bilderkennung nennt unter anderem Bildbeschreibungen, Klassifikation und Fragen zu einem Bild. Ein praktisches Beispiel: Ein Foto eines Whiteboards wird gemeinsam mit der Bitte eingereicht, die sichtbaren Aufgaben zu ordnen. Die Frage lenkt die Auswertung auf das gewünschte Ergebnis.
Dabei ist eine saubere Arbeitsanweisung hilfreich: Erst sichtbaren Text erfassen, dann offene Stellen markieren und erst anschließend zusammenfassen. So kann die anfragende Person erkennen, ob das System eine handschriftliche Notiz tatsächlich gelesen oder einen plausiblen Zusammenhang ergänzt hat. Das ist ein vorgeschlagener Arbeitsablauf, kein garantiertes Merkmal jedes Produkts.
Ein Ausschnitt kann entscheidende Informationen ausblenden. Bei einem Diagramm sollten deshalb Titel, Achsen, Einheiten und Legende sichtbar sein. Bei einem Dokument ist eine gut lesbare Datei oft hilfreicher als ein schräg aufgenommenes Foto. Auch die Frage muss zum Material passen: Aus einer Kurve allein lässt sich etwa nicht sicher ableiten, warum sich ein Markt verändert hat.
Eine nützliche Prüffrage lautet: Welche Aussage stammt direkt aus dem hochgeladenen Material, welche ist eine Schlussfolgerung? Für das Whiteboard könnte die Antwort zwischen sicher gelesenen Namen, unsicheren Wörtern und vorgeschlagenen Zuständigkeiten unterscheiden. Wer das Ergebnis weiterverwendet, prüft die entscheidenden Details am Original. Multimodalität erweitert das Arbeitsmaterial; sie ersetzt nicht die Kontrolle der daraus gezogenen Aussagen.
Die verlinkten Originalquellen ermöglichen die eigene Prüfung und Vertiefung.
Dieser Beitrag wurde mit KI-Unterstützung anhand der angegebenen Quellen erstellt. Stand des Beitrags: 02.11.2026. Produktangaben können sich ändern. Ein eigener Produkt- oder Tooltest wurde nicht durchgeführt. Mehr über unseren Ansatz →
Eine KI kann Antworten mit gefundenen Unterlagen verbinden. Entscheidend ist dabei, welche Dokumente sie findet – und ob sie diese richtig verwendet.
Nicht jede KI-Aufgabe braucht das größte Modell. Kleinere Systeme können interessant sein – wenn Leistung, Betrieb und Nutzungsbedingungen zusammenpassen.